Tak for det hurtige svar. Min live- og historikovervågning er helt tom (selvom der er blevet udført aktiviteter, og også når jeg vælger flere poster pr. side), så jeg kan ikke udføre det ovenstående.
Det er også nyt for mig; normalt blev historikken vist fint her.
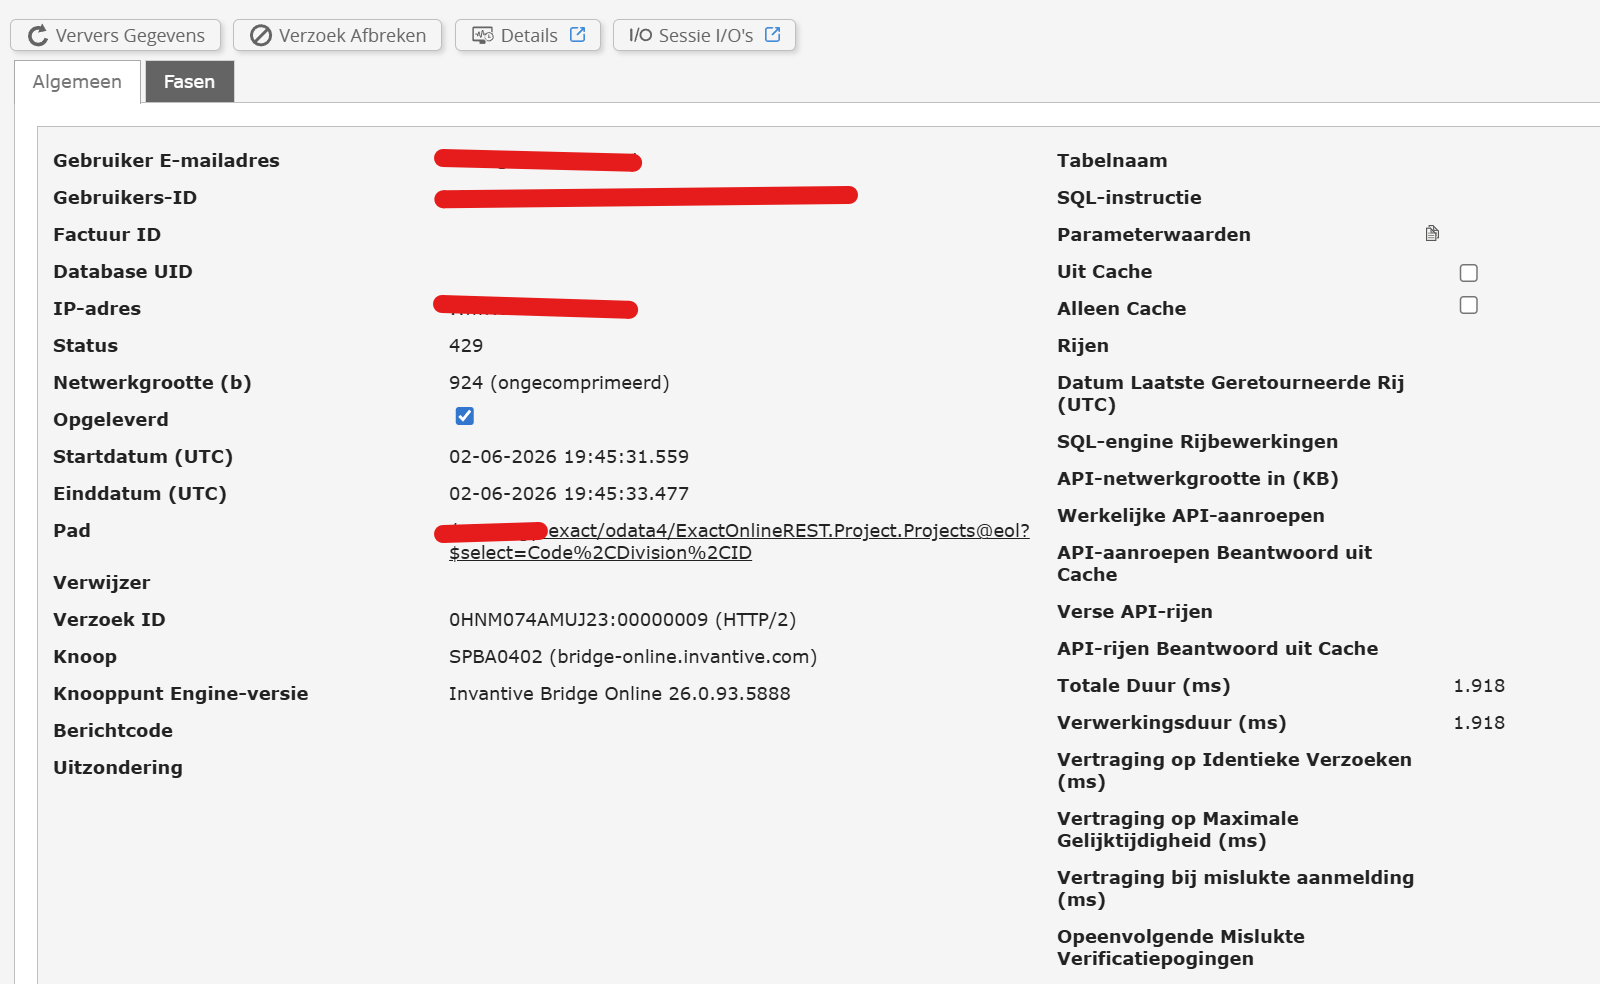
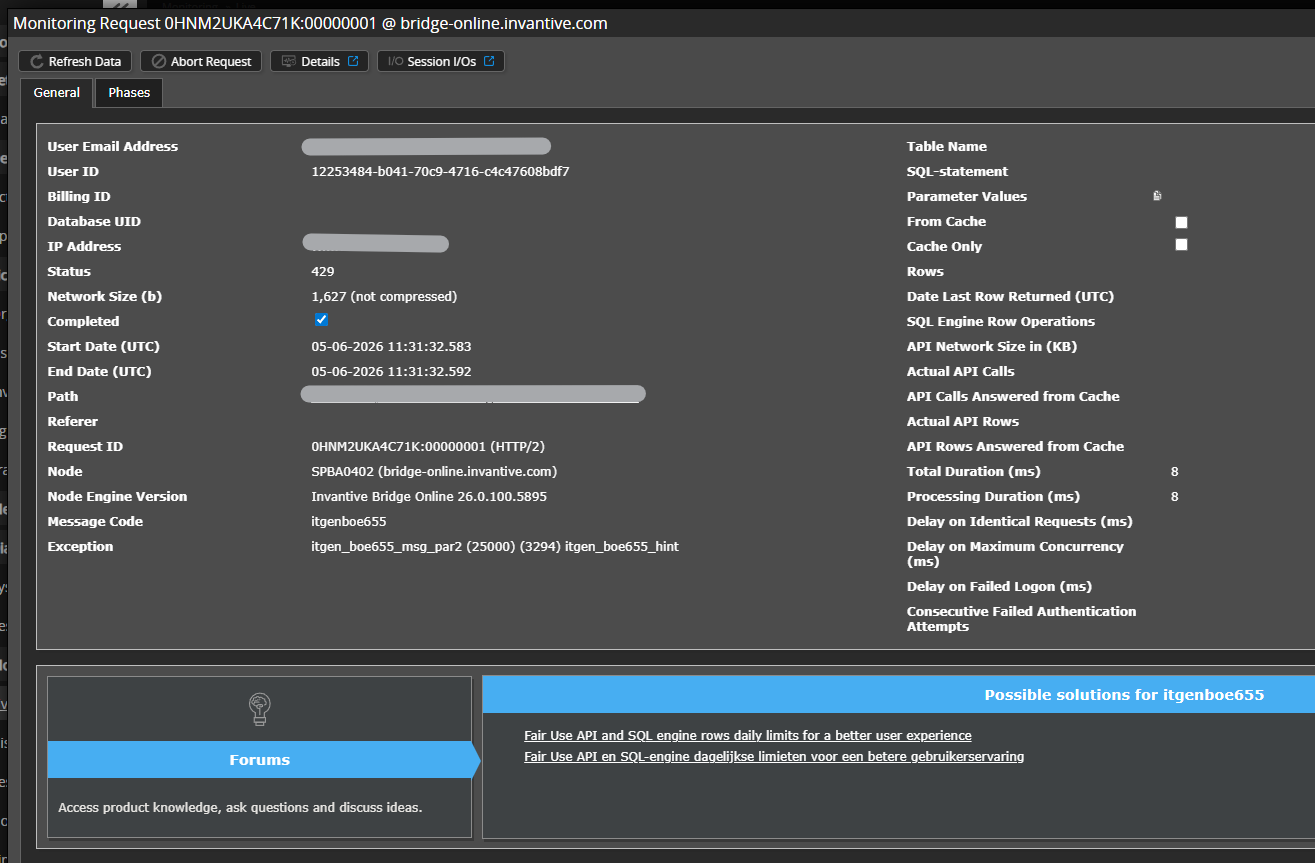
itgenboe405 angiver, at den totale varighed pr. dag er overskredet (TotalDurationMsPerDay).
Rådet er at optimere den totale varighed af alle anmodninger. Den tilladte varighed i denne form er 1 time, men der har været cirka 4 timers kontinuerlig aktivitet.
En oversigt over alle fejlkoder, der fører til en 429, kan findes på:
Gælder denne 1 time pr. database eller i det hele taget?
I øvrigt synes jeg selv, at varigheden er meget lang, især da mine kunder har nogle tabeller med ca. 400k (2 til 3) og resten alle små dimensioner. Opdateringstider ved fuld belastning varer omkring 30-45 minutter.
Er der noget, der kan gøres ved databasekonfigurationen for at fremskynde dette? For eksempel sidestørrelser?
Okay, så antallet af API-opkald per dag kan jeg se. Gælder dette dog per database? Eller bliver grænsen anvendt på alle databaser, så snart den er overskredet et sted?
Alle grænser gælder på tværs af alle aktiviteter i et miljø, altså også på tværs af databaser.
Grænserne er generelt meget rummeligt dimensionerede. Skulle du dog alligevel støde på dem, er rådet at se på, hvilke handlinger der kræver en uforholdsmæssigt urimelig del af grænsen, og optimere dette.
Jeg har kigget på monitoreringsoutputtet, og jeg kan faktisk se en del dobbeltarbejde, men når jeg kigger på min egen kode i Power BI, er koden i sig selv ikke ineffektiv, men den iboende opsætning af PowerBI:
For hver forespørgsel bliver metadata (odata4/$metadata) efterspurgt igen, selvom det er de samme metadata. Staging-tabeller er derudover ikke mulige, hvilket betyder, at hver forespørgsel sender en forespørgsel til Invantive igen. For eksempel for salgsordretabellen (ExactOnlineREST.SalesOrder.SalesOrderLines@eol):
09-06-2026 01:10:21
09-06-2026 01:13:40
09-06-2026 01:15:11
09-06-2026 01:18:30
09-06-2026 01:20:01
Da connectoren er beregnet til Power BI, og dette er et iboende problem ved måden at opdatere i PBI selv, ved jeg ikke rigtig, hvad jeg kan gøre.
Derudover punktet: Hvis grænsen gælder for hele mit miljø på OEM, og der er tilknyttet 4 kunder med hver deres daglige opdatering, når jeg meget hurtigere denne grænse, end hvis disse 4 kunder havde deres egen konto. Mens jeg betaler det samme som de 4 kunder tilsammen. Ikke sandt?
Hver opdatering pr. miljø har en varighed på ca. 1500 sekunder, hvilket er fint med en grænse på 10k. Med 4 miljøer (og jeg håber at tilføje flere) er det 6000 pr. dag. Med udvikling og eventuelt et ekstra opdateringsmoment i løbet af dagen når jeg meget hurtigt over de 10k.
Tak for svaret. SalesOrderLines har jeg brugt i stedet for bulk, fordi der i ikke-bulkversionen er nogle kolonner, som ikke findes i bulkversionen. Jeg har dog kunnet accelerere processen betydeligt ved at anvende filtrering tidligere. Jeg vil også gøre dette for andre forespørgsler, så folding ikke bryder sammen.
Et andet stort bidrag til opdateringstiden er ‘odata4/$metadata’. Er der noget, der kan gøres ved dette, eller er det iboende i antallet af forespørgsler, der kører?
Hvis det er som det skal være, så kan alle felter i SalesOrderLines også findes i SalesOrderLinesBulk og omvendt. Hvilke specifikke felter mangler?
At hente $metadata bør kun tage nogle få millisekunder efter den første hentning. Rådet er at kontrollere, at der ikke er for mange samtidige forespørgsler, som får dem til at vente længere.
Fra og med release 26.0.285 vil den tid, der rapporteres ved koden itgenboe405, ikke længere inkludere ventetiden, men kun eksekveringstiden. Dette øger den tilgængelige kapacitet, især hvis en proces er løbet af sporet, eller hvis der kommer mange anmodninger samtidigt, hvor en del skal vente.
Dette spørgsmål er automatisk blevet lukket efter 1 uges inaktivitet. Det senest givne svar er markeret som løsningen.
Venligst opret et nyt spørgsmål i et separat emne, hvis problemet opstår igen. Inkluder venligst et link til dette emne i det nye spørgsmål ved at indsætte URL’en i teksten.