Jag håller på att byta min Power BI-anslutning från Davista till Invantive. I princip går det ganska smidigt, bortsett från en hel del petgöra.
Men på dagen för driftsättningen får jag från flera Power BI-användare meddelanden om att de har fått varningen att kapaciteten på 2 GB arbetsminne har uppnåtts. Min datamodell är 44 MB, min största tabell har 140k rader och problemet uppstår även med mycket enkla measures. Vad gäller volym/komplexitet är det alltså absolut inget problem.
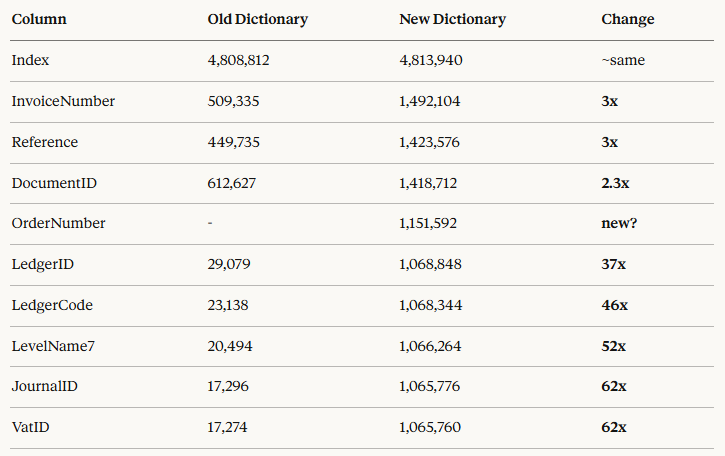
Efter lite undersökning verkar det bero på att datan som levereras av Invantive har orsakat enorma ökningar i dictionary-storleken. Här en översikt över min största tabell (old = Davista, new = Invantive):
VatID har ungefär 12 unika värden hos båda anslutningarna och borde alltså ha en mycket liknande dictionary-storlek. Har ni någon förklaring och lösning på detta?
Ursäkta förvirringen kring terminologin. Vad innebär egentligen hela konceptet “old dictionary” och “new dictionary” från bilden? Hur tas de fram, och var kan man hitta dokumentation om detta?
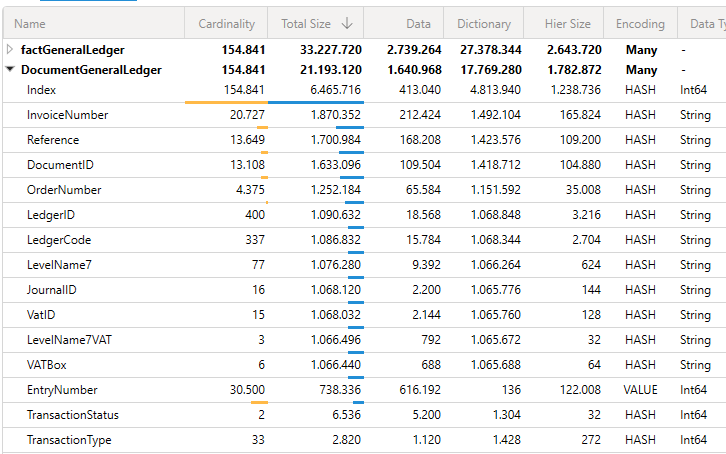
Det här är resultatet av VertiPaq Analyzer i DAX Studio. Nedan visas Analyzer-utdatan. Kolumner med låg kardinalitet har enorm påverkan på tabellens totala storlek och därmed på hela modellens storlek:
Det verkar inte vara en slump att alla kolumner har en nästan identisk storlek på ~1 068 000. Det ser ut som om ett fast overhead läggs till via flödet, oavsett kolumnens dynamik.
Kolumnen Dictionary i VertiPaq Analyzer visar hur mycket minne Power BI internt använder för att lagra de unika värdena i en kolumn.
Problemet: när samma data (samma värden, samma datatyper, samma antal rader) laddas in via Invantive Cloud OData istället för via den gamla Davista-anslutningen, använder Power BI 30-60 gånger mer minne per kolumn. Detta orsakar „Resource Governance”-minnesfel hos våra slutanvändare.
Ett konkret exempel — kolumnen VatID med 15 unika textvärden:
Via Davista: 17 KB minnesanvändning
Via Invantive OData: 1 065 KB minnesanvändning
Detta mönster gäller för alla kolumner, oavsett kardinalitet. Kolumner med 3 unika värden använder lika mycket minne som kolumner med 400 unika värden (~1 MB per kolumn).
Detta tyder på att OData-svaret från Invantive innehåller något — extra utfyllnad, metadata, eller en annan sträng-kodning — som gör att Power BI-motorn komprimerar datan mindre effektivt.
Min fråga: skulle ni kunna undersöka hur OData-flödet returnerar sträng-värdena? Specifikt: vilken kodning som används (UTF-8 kontra UTF-16), om efterföljande blanksteg eller osynliga tecken skickas med, och om det finns någon skillnad i OData-svarets formatering jämfört med Davista?
Det som beskrivs är en mekanism som Invantive UniversalSQL också använder flitigt internt för att begränsa minnesanvändningen (memory footprint) för stora resultatuppsättningar med mycket upprepning.
Det finns inget känt problem med att data returneras i olika varianter. OData-flödet innehåller endast registreringen, utan utfyllnad (padding) eller liknande.
OData-datan kan ses som läsbar text genom att öppna URL:en för förfrågan i Invantive Cloud Monitoring via din webbläsare. Kodningen kan också ses där via HTTP-headers i DevTools i Edge, eller webbläsare baserade på Chromium.
Det går inte att utesluta att detta är en begränsning hos Microsoft-drivrutinen. Om så är fallet finns det några alternativ:
Använd en Power BI-miljö som inte begränsas av 32-bitars minnesgränsen.
Jämför minnesanvändningen med TDS-åtkomstpunkten (Microsoft SQL Server) i Invantive Cloud, som för närvarande är i BETA.
Begränsa antalet rader och/eller kolumner.
Rapportera problemet till Microsoft.
Om du mot förmodan ändå skulle hitta olika representationer för samma värden (text, tal, GUID eller annat) i OData-flödet, lägg då gärna till några exempel, inklusive uppgift om tabell- och kolumnnamn.
Tack för svaret. Jag hade redan en känsla av att om det verkligen levererades så här av er, så hade ni nog stött på det här problemet oftare. Jag tar upp det med Microsoft, även om jag är rädd att de inte är lika snabba och hjälpsamma som ni
Tack för det uttalade förtroendet i vår tjänstvillighet. Det lyckas inte alltid och ibland helt enkelt inte, men avsikten är att vara till så god hjälp som möjligt.
Även om skärmen inte var bekant för oss, delar Invantive UniversalSQL faktiskt ett stort antal begrepp med Power Query. Det gäller även ett antal tekniska element. Båda körs på en PC med Microsoft .net. Inom Microsoft .net är varje text (”string”) olika, även om flera har samma värde. Detsamma gäller för många andra datatyper.
Att dela värden är möjligt på olika sätt, men kräver egentligen alltid ett medvetet övervägande från programmerarens sida. Felaktiga avvägningar kan få stora negativa konsekvenser, såsom minnesläckor. Mer förklaring om detta koncept finns att läsa på:
UniversalSQL-motorn kommer i allmänhet att hålla kvar och centralt komma ihåg ett mycket begränsat antal värden om det är känt att de ofta återkommer. Tänk på konstanter, företagsnamn och liknande.
Därutöver arbetar motorn med resultatmängder (”result set”). Dessa baseras i allmänhet på ”sparse arrays”, det vill säga en serie värden som tillsammans beskriver de icke-tomma värdena i en rad. ”Sparse” eftersom det finns ”hål” i dem för att begränsa minnesanvändningen vid tabeller med tusentals (ofta tomma) kolumner.
Till en resultatmängd hör vanligtvis en serie delade objekt. Texter, till exempel, lagras centralt här, så att det vid upprepning endast krävs en referens till dem. På olika sätt komprimeras och frigörs dessa serier av delade objekt under bearbetningen. Ett historiskt exempel visar detta tydligt: en frågeresultatmängd som innehöll 4,5 terabyte data på grund av ett skrivfel av den som skrev detta, fick plats i 32 GB arbetsminne.
Detta arbetssätt säkerställer också att det är osannolikt att olika texter kommer ut på utdatasidan; de delar samma grund.
Power Query verkar använda en liknande mekanism vid tillämpning av joins, vilket tydligen är implementerat som en ”hash join”. Detta är även en av join-strategierna inom UniversalSQL, men UniversalSQL har även en så kallad ”nested loop join”. Via exempelvis SQL-tipset join_set kan man också växla mellan dem.
Vid fyllning av en översättningstabell (”dictionary”) med hashar är det nödvändigt att under tilläggandet kontrollera om ett värde redan finns. Detta är inte alltid trivialt i Microsoft .net.
Denna fråga har automatiskt stängts efter 1 veckas inaktivitet. Det senaste svaret har markerats som lösning.
Vänligen ställ en ny fråga i ett separat ämne om problemet uppstår igen. Vänligen inkludera en länk till detta ämne i den nya frågan genom att klistra in dess URL i texten.