Sammendrag
Invantive SQL og PSQL tilbyr utvidelser for å utføre native forespørsler, enten det er HTTP- eller SQL-forespørsler, på den underliggende plattformen til hver datacontainer i en distribuert database. Dette notatet introduserer prosessflyten og SQL-optimizeren. Deretter vises eksempler med bruk av SQL med skalare native forespørsler med ett resultat, og bruk av PSQL med skalar enkeltverdi, rad-nivå og mengdebaserte resultater.
Global SQL-database
Invantive SQL lar deg opprette en global database som spenner over datakilder over hele verden. Hver datakildetilkobling kalles en «datacontainer». Hver global database definerer et antall datacontainere som enten er:
- filbaserte, som XML, JSON, CSV eller Excel;
- tradisjonelle SQL-baserte, som Oracle eller PostgreSQL;
- skybaserte, som Exact Online eller Company.info.
Invantive SQL-motoren oversetter SQL-setninger til operasjoner som gjelder for plattformen. For eksempel blir en SQL-select på én filbasert kilde, som en Payroll Audit File, oversatt til:
- tolkning av XML-ens metadata,
- tilpasning av datamodellen til metadataene,
- lesing og parsing av filinnholdet,
- filtrering av det aktuelle resultatsettet.
Men en SQL-select på Exact Online vil ikke bli oversatt til filoperasjoner, men til XML- og OData-baserte operasjoner. SQL-setninger kan også kombinere flere datakilder i én SQL-select-setning. Til slutt, avhengig av plattformens muligheter, kan data endres og datamodellen endres på datakilden ved hjelp av Invantive SQL-setninger.
SQL-optimizer
Noen Invantive SQL-installasjoner håndterer relasjonelle data i terabyte-området. Med en slik datamengde vil en enkel brute force-tilnærming til utførelse av SQL-setninger ikke gi resultater i løpet av dette livet, så en såkalt «optimizer» hjelper vår Invantive SQL-motor. Optimizeren hjelper Invantive SQL-motoren med å velge den beste utførelsesmetoden for SQL-setninger blant de ulike mulighetene. «Best» er definert med hensyn til å begrense utførelsesmetoden ved å minimere på én eller flere dimensjoner, som utførelsestid, disk-I/O eller nettverk.
Snakk native
Plattformene som datacontainerne kjører på, tilbyr funksjonalitet som Invantive SQL ikke har noen representasjon for, eller kanskje aldri vil få, på grunn av konflikter med designvisjonen bak Invantive SQL. For eksempel tilbyr PostgreSQL-plattformene arrays som en datatype, men vår nåværende visjon om arrays er at disse logisk sett representerer poster, så en separat logisk tabell ville være et mer logisk valg slik vi ser det per nå. Det samme gjelder for enkelte funksjoner på andre plattformer, som Oracle, Exact Online eller Company.info.
Uansett, med PostgreSQL som et gjennomgående eksempel, åpner muligheten til å bruke slike spesifikke funksjoner for nye veier til å hjelpe deg videre med å nå designmålene dine, enten det er skalerbarhet, vedlikeholdbarhet, kompatibilitet eller noe annet. Derfor tilbyr Invantive SQL støtte både i SQL og Procedural Options for å «snakke native» med plattformen.
For skyplattformer betyr dette typisk at man bruker den samme datatransportkanalen for API-forespørsler til å utføre nøye håndskrevne HTTP-forespørsler. For SQL-baserte plattformer gjør dette det mulig å kjøre plattformens egen SQL-syntaks direkte, uten noen oversettelser, verifikasjoner eller håndtering av Invantive SQL.
Native med Invantive SQL
For bruk innenfor Invantive SQL finnes det en tabell kalt NativePlatformScalarRequests som er knyttet til hver datacontainer.
Innsettingshandlinger (insert) i tabellen NativePlatformScalarRequests resulterer i at innholdet (payload) blir transportert og utført på plattformen tilknyttet datacontaineren.
De tilgjengelige feltene er:
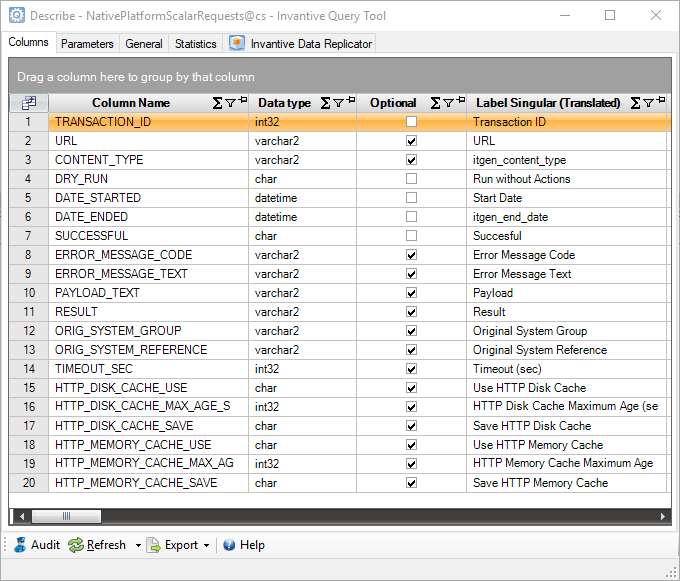
En typisk native forespørsel for en ANSI SQL-basert datacontainer kan se slik ut:
--
-- Fjern alle rader i den ikke-aggregerte tabellen med en opprettelsesdato
-- før den sist opprettede raden i den aggregerte tabellen.
--
insert into NativePlatformScalarRequests@DATA_CONTAINER_ALIAS
( payload_text
)
values
( 'delete from unaggregated where date_created < ( select max(date_created) from aggregated)'
)
Innsettingen (insert) av native plattformforespørsler venter til den forespurte native forespørselen er fullført. Tabellen NativePlatformScalarRequests vil, når den spørres opp etterpå, inneholde én rad for hver forespørsel, inkludert resultatene og om den ble utført uten feil. Kolonnen ORIG_SYSTEM_REFERENCE kan brukes som en tilgjengelig primærnøkkel for å finne riktig rad.
Som standard vil en feil som oppstår på plattformen under utførelse av forespørselen, ikke bli videreført til Invantive SQL. Koden din må sjekke innholdet i tabellen NativePlatformScalarRequests for å avgjøre utfallet og eventuell passende handling.
Bruken av kolonnene URL, CONTENT_TYPE og kolonnene hvis navn starter med HTTP_ er beregnet for bruk med skybaserte plattformer.
Native med Invantive PSQL
Innenfor Invantive PSQL kan du selvfølgelig bruke NativePlatformScalarRequests som i Invantive SQL. Men Invantive PSQL tilbyr også integrerte prosedurale funksjoner for å utføre native forespørsler.
For enkle skalare eller rad-nivå-forespørsler kan du bruke execute native-setningen. I følgende eksempel kjøres en native PostgreSQL SQL-spørring ved hjelp av PSQL. Spørringen returnerer én eller flere skalare verdier som lagres i PSQL-variabler:
create table runs@inmemorystorage
( outcome date
)

declare
  l_native_date_retrieved date;
begin
  execute native 'select (now() + interval ''4 hours'')::date'
  into l_native_date_retrieved
  datacontainer 'DATA_CONTAINER_ALIAS'
  ;
  insert into runs@inmemorystorage
  ( outcome
  )
  values
  ( l_native_date_retrieved
  );
end;

select * from runs@inmemorystorage
For native spørringer som returnerer flere rader med data, tilbyr PSQL en utvidelse til for…loop…end loop-setningen.
Når den native SQL-en returnerer rader, blir de behandlet rad for rad, akkurat som med en vanlig for…loop…end loop-setning:
( outcome datetime
)

begin
  for r in ( execute native 'select now() c union select now()::date c' datacontainer 'DATA_CONTAINER_ALIAS')
  loop
    insert into runs@inmemorystorage
    ( outcome
    )
    values
    ( r.c
    );
  end loop;
end;

select * from runs@inmemorystorage
Utdataene vil ligne på følgende bilde:
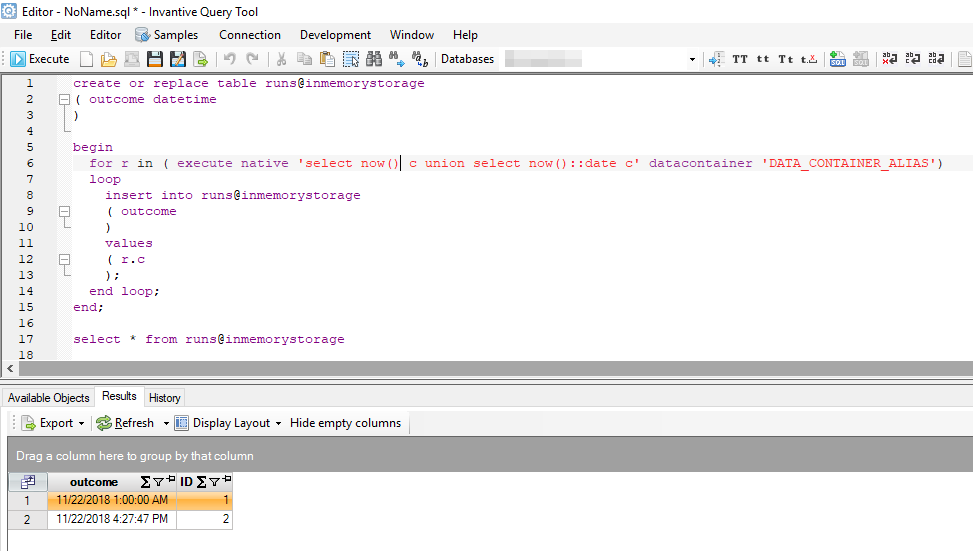
Merk at den første raden i resultatene er datert til kl. 01:00 i stedet for kl. 00:00. I dette scenarioet kjørte Invantive SQL én tidssone unna databaseserveren som utførte den native SQL-setningen. En tidssonekompensasjon ble gjort underveis, men generelt er det teknisk mindre krevende å avstå fra slike komplekse scenarioer i applikasjonene dine.
Utfør native prosedural SQL med utdata
Mange tradisjonelle databaseplattformer tilbyr en måte å returnere resultater på ved hjelp av print-setninger. For eksempel på Oracle vil følgende Oracle PL/SQL skrive ut «hello world» til en dbms_output-aktivert SQL-klient, som SQL*Plus eller TOAD:
begin
   dbms_output.put_line('hello world');
end;
Slik prosedural SQL på den underliggende plattformen kan også kjøres direkte ved hjelp av execute native, mens utdataene samles inn og skrives ut av Invantive SQL-klientproduktene.
Bruk følgende setning for å kjøre det forrige eksempelet direkte fra Invantive PSQL:
begin
  execute native 'begin dbms_output.put_line(''hello world''); end;' datacontainer 'ora';
end;
Typisk utdata er:
01-01-1970 08:41:20.35012 PRINT hello world