Samenvatting
Invantive SQL en PSQL bieden uitbreidingen om native verzoeken uit te voeren, of het nu HTTP- of SQL-verzoeken zijn, op het onderliggende platform van elke datacontainer in een gedistribueerde database. Deze notitie introduceert de procesflow en de SQL-optimizer. Daarna worden voorbeelden getoond waarbij SQL wordt gebruikt met scalaire native verzoeken met één resultaat, en PSQL met scalaire, rij-niveau en set-gebaseerde resultaten.
Globale SQL-database
Met Invantive SQL kun je een globale database creëren die databronnen over de hele wereld omvat. Elke databronverbinding wordt een „datacontainer" genoemd. Elke globale database definieert een aantal datacontainers, die kunnen zijn:
- bestandsgebaseerd, zoals XML, JSON, CSV of Excel;
- traditioneel SQL-gebaseerd, zoals Oracle of PostgreSQL;
- cloud-gebaseerd, zoals Exact Online of Company.info.
De Invantive SQL-engine vertaalt SQL-statements naar bewerkingen die van toepassing zijn op het platform. Een SQL-select op bijvoorbeeld één bestandsgebaseerde bron, zoals een Payroll Audit File, wordt vertaald naar:
- het interpreteren van de metadata van de XML,
- het matchen van het datamodel op de metadata,
- het lezen en parsen van de bestandsinhoud,
- het filteren van de juiste resultaatset.
Maar een SQL-select op Exact Online zou niet vertaald worden naar bestandsbewerkingen, maar naar XML- en OData-gebaseerde bewerkingen. SQL-statements kunnen ook meerdere databronnen combineren in één SQL-select statement. Ten slotte kunnen, afhankelijk van de mogelijkheden van het platform, gegevens worden gewijzigd en kan het datamodel op de databron worden aangepast met behulp van Invantive SQL-statements.
SQL-optimizer
Sommige Invantive SQL-installaties verwerken relationele gegevens in het terabyte-bereik. Bij een dergelijke hoeveelheid gegevens levert een simpele brute-force-aanpak bij de uitvoering van een SQL-statement geen resultaten op binnen dit leven, dus wordt onze Invantive SQL-engine ondersteund door een zogenaamde „optimizer". De optimizer helpt de Invantive SQL-engine bij het kiezen van de beste uitvoeringsaanpak voor SQL-statements uit de verschillende mogelijkheden. „Beste" wordt gedefinieerd in termen van het beperken van de uitvoeringsaanpak door te minimaliseren op één of meerdere dimensies, zoals uitvoeringstijd, schijf-I/O of netwerk.
Native spreken
De platforms waarop de datacontainers draaien, bieden mogelijkheden waarvoor Invantive SQL geen representatie heeft, of misschien ooit zal hebben vanwege conflicten met de ontwerpvisie achter Invantive SQL. Zo biedt het PostgreSQL-platform bijvoorbeeld arrays als datatype, maar onze huidige visie op arrays is dat deze logisch gezien records voorstellen, dus een aparte logische tabel zou volgens onze huidige inzichten een logischere keuze zijn. Hetzelfde geldt voor sommige functies van andere platforms, zoals Oracle, Exact Online of Company.info.
Toch opent, met PostgreSQL als lopend voorbeeld, de mogelijkheid om dergelijke specifieke functies te gebruiken nieuwe wegen om je te helpen je ontwerpdoelen verder te bereiken, of het nu gaat om schaalbaarheid, onderhoudbaarheid, compatibiliteit of wat dan ook. Daarom biedt Invantive SQL ondersteuning, zowel in SQL als in Procedural Options, om „native te spreken" met het platform.
Voor cloudplatforms vertaalt dit zich doorgaans naar het gebruik van hetzelfde datatransportkanaal voor API-verzoeken om zorgvuldig handmatig geschreven HTTP-verzoeken uit te voeren. Voor SQL-gebaseerde platforms kun je hiermee de eigen SQL-syntaxis van het platform rechtstreeks uitvoeren, zonder enige vertaling, verificatie of afhandeling door Invantive SQL.
Native met Invantive SQL
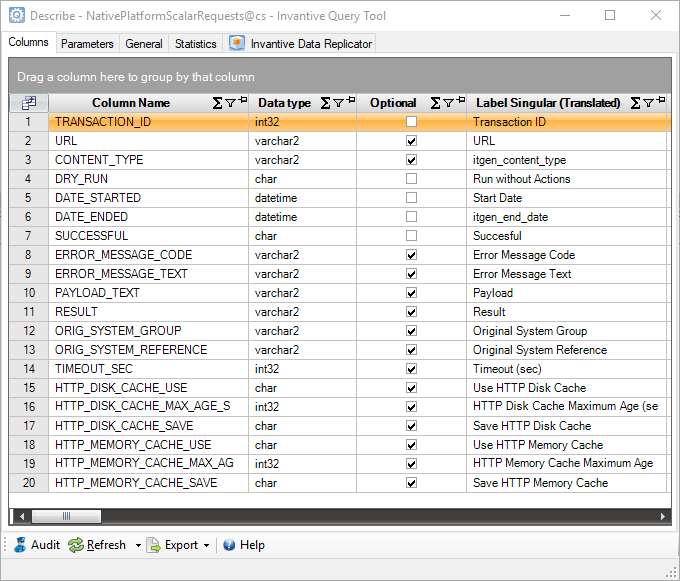
Voor gebruik binnen Invantive SQL is er een tabel genaamd NativePlatformScalarRequests die bij elke datacontainer hoort.
Insert-acties in de tabel NativePlatformScalarRequests resulteren erin dat de payload wordt getransporteerd en uitgevoerd op het platform dat bij de datacontainer hoort.
De beschikbare velden zijn:
Een typisch native verzoek voor een op ANSI SQL gebaseerde datacontainer zou er zo uit kunnen zien:
--
-- Verwijder alle rijen in de niet-geaggregeerde tabel met een aanmaakdatum
-- vóór de laatst aangemaakte rij in de geaggregeerde tabel.
--
insert into NativePlatformScalarRequests@DATA_CONTAINER_ALIAS
( payload_text
)
values
( 'delete from unaggregated where date_created < ( select max(date_created) from aggregated)'
)
De insert op de native platformverzoeken wacht totdat het gevraagde native verzoek is afgerond. De tabel NativePlatformScalarRequests bevat, wanneer deze daarna wordt bevraagd, één rij per verzoek, inclusief de resultaten en of de uitvoering succesvol was. De kolom ORIG_SYSTEM_REFERENCE kan gebruikt worden als een opgegeven primaire sleutel om de juiste rij te vinden.
Standaard komt een fout die door het platform wordt opgeworpen tijdens de uitvoering van het verzoek niet door naar Invantive SQL. Je code moet de inhoud van de tabel NativePlatformScalarRequests controleren om de uitkomst te bepalen en eventuele passende actie te ondernemen.
Het gebruik van de kolommen URL, CONTENT_TYPE en de kolommen waarvan de naam begint met HTTP_ is bedoeld voor gebruik met cloudgebaseerde platforms.
Native met Invantive PSQL
Binnen Invantive PSQL kun je natuurlijk NativePlatformScalarRequests gebruiken zoals in Invantive SQL. Maar Invantive PSQL biedt ook geïntegreerde procedurele functies om native verzoeken uit te voeren.
Voor eenvoudige scalaire of rij-niveau verzoeken kun je de execute native statement gebruiken. In het volgende voorbeeld wordt een native PostgreSQL SQL-query uitgevoerd met PSQL. De query retourneert één of meer scalaire waarden die worden onthouden in PSQL-variabelen:
create table runs@inmemorystorage
( outcome date
)

declare
  l_native_date_retrieved date;
begin
  execute native 'select (now() + interval ''4 hours'')::date'
  into l_native_date_retrieved
  datacontainer 'DATA_CONTAINER_ALIAS'
  ;
  insert into runs@inmemorystorage
  ( outcome
  )
  values
  ( l_native_date_retrieved
  );
end;

select * from runs@inmemorystorage
Voor native queries die meerdere rijen aan gegevens retourneren, biedt PSQL een uitbreiding op het for…loop…end loop statement.
Wanneer de native SQL rijen retourneert, worden deze rij voor rij verwerkt, net als bij een normaal for…loop…end loop statement:
( outcome datetime
)

begin
  for r in ( execute native 'select now() c union select now()::date c' datacontainer 'DATA_CONTAINER_ALIAS')
  loop
    insert into runs@inmemorystorage
    ( outcome
    )
    values
    ( r.c
    );
  end loop;
end;

select * from runs@inmemorystorage
De uitvoer lijkt op de volgende afbeelding:
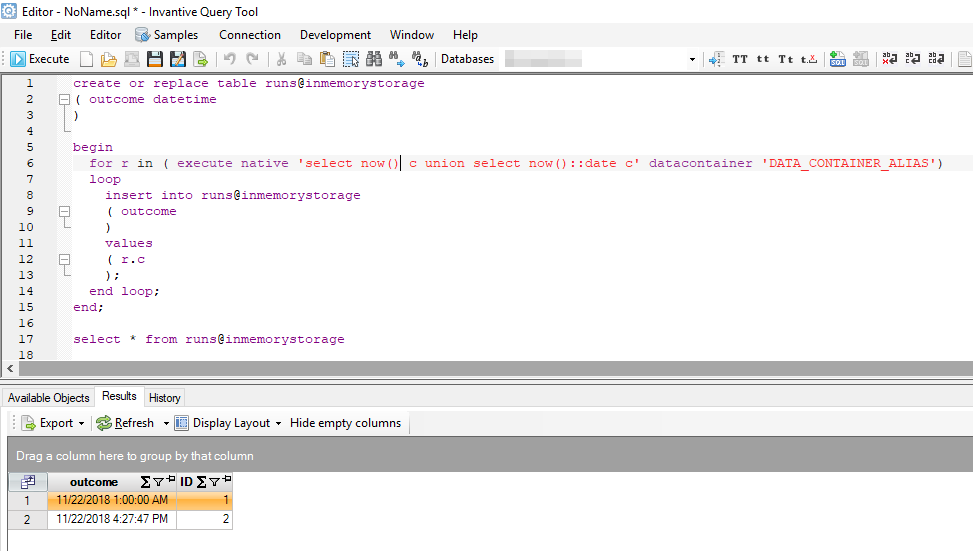
Let op: de eerste rij van de resultaten heeft een datum van 1 uur 's nachts in plaats van 12 uur 's nachts. In dit scenario liep Invantive SQL één tijdzone verschillend van de databaseserver die het native SQL-statement uitvoerde. Er werd onderweg een tijdzonecompensatie toegepast, maar in het algemeen is het technisch minder belastend om dergelijke complexe scenario’s in je applicaties te vermijden.
Native procedurele SQL uitvoeren met output
Veel traditionele databaseplatforms bieden een manier om resultaten te retourneren met behulp van print-statements. Op Oracle drukt bijvoorbeeld de volgende Oracle PL/SQL ‘hello world’ af naar een dbms_output-ondersteunde SQL-client zoals SQL*Plus of TOAD:
begin
   dbms_output.put_line('hello world');
end;
Dergelijke procedurele SQL op het onderliggende platform kan ook direct worden uitgevoerd met execute native, waarbij de output wordt verzameld en afgedrukt door Invantive SQL-clientproducten.
Gebruik het volgende statement om het vorige voorbeeld rechtstreeks vanuit Invantive PSQL uit te voeren:
begin
  execute native 'begin dbms_output.put_line(''hello world''); end;' datacontainer 'ora';
end;
Typische output is:
01-01-1970 08:41:20.35012 PRINT hello world