2vpg
2026 年 2 月 26 日午後 3:19
1
現在、Power BIの接続をDavistaからInvantiveに切り替えている最中です。基本的には順調に進んでいますが、かなり細かい調整作業が必要です。
しかし、本番稼働初日に、複数のPower BIユーザーから「2GBのメモリ容量に達した」というメッセージが表示されたという報告を受けました。私のデータモデルは44MBで、最大のテーブルでも14万行程度です。また、この問題は非常にシンプルなメジャーでも発生しています。つまり、データ量や複雑さの面ではまったく問題にならないはずです。
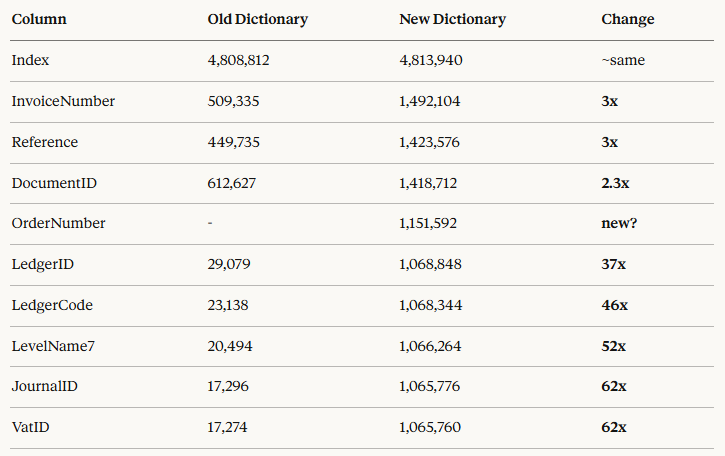
調査したところ、Invantiveから出力されるデータによって、辞書サイズが大幅に増加していることが原因のようです。以下は最大のテーブルの比較です(old = Davista、new = Invantive):
VatIDはどちらのコネクタでもユニークな値が約12個しかないため、辞書サイズはかなり近いはずです。この件について、何か説明や解決策はありますでしょうか?
forums
2026 年 2 月 26 日午後 3:27
2
「old dictionary」と「new dictionary」とは何を意味しますか?
2vpg
2026 年 2 月 26 日午後 3:29
3
「Old」はDavistaに基づく私のデータセット/モデルで、「New」はInvantiveに基づいています
forums
2026 年 2 月 26 日午後 3:31
4
言葉の行き違いについてお詫びします。画像にある「old dictionary」と「new dictionary」という概念全体は何を意味しているのでしょうか?それらはどのようにして作られるのか、あるいはこれに関するドキュメントはどこで見つけられますか。
2vpg
2026 年 2 月 26 日午後 3:34
5
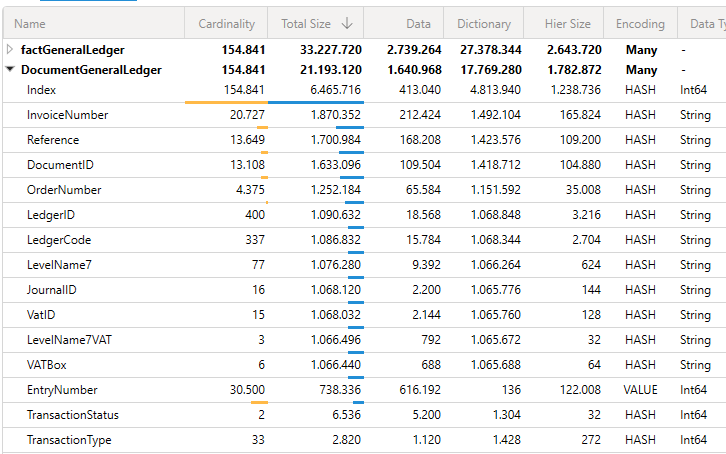
これはDAX StudioのVertiPaq Analyzerの結果です。以下はAnalyzerの出力です。カーディナリティの低い列は、テーブル全体のサイズ、ひいてはモデル全体に非常に大きな影響を与えます。
すべての列がほぼ同一のサイズ(約1,068,000)を持っているのは偶然ではないように思えます。これは、列の動的な性質に関係なく、フィードによって固定のオーバーヘッドが付加されているかのようです。
forums
2026 年 2 月 26 日午後 4:09
7
問題を特定することができません。これについてもっと詳しい情報、またはあなたが言いたいことが書かれている参考ページを提供していただけますか?
2vpg
2026 年 2 月 26 日午後 4:12
8
VertiPaq Analyzer の Dictionary 列には、Power BI が列のユニークな値を格納するために内部的にどれだけのメモリを使用しているかが表示されます。
問題点:同じデータ(同じ値、同じデータ型、同じ行数)を、従来の Davista コネクタではなく Invantive Cloud OData 経由で読み込むと、Power BI が列ごとに30〜60倍も多くのメモリを使用します。これがエンドユーザー側で「Resource Governance」のメモリエラーを引き起こしています。
具体例として、15個のユニークなテキスト値を持つ VatID 列の場合:
このパターンはカーディナリティに関係なく、すべての列に当てはまります。3個のユニークな値を持つ列も、400個のユニークな値を持つ列も、同程度のメモリ(列あたり約1 MB)を使用しています。
これは、Invantive の OData レスポンスに何か——余分なパディング、メタデータ、あるいは別の文字列エンコーディング——が含まれており、それが原因で Power BI エンジンがデータを効率的に圧縮できていないことを示唆しています。
質問なのですが、OData フィードが文字列値をどのように返しているか調査していただけますでしょうか?具体的には、どのエンコーディング(UTF-8 か UTF-16 か)が使用されているか、末尾の空白や不可視文字が含まれていないか、そして Davista と比べて OData レスポンスのフォーマットに違いがあるかどうかを確認していただきたいです。
forums
2026 年 2 月 26 日午後 4:43
9
ご説明いただきありがとうございます。
ここで説明されている内容は、繰り返しの多い大規模な結果セットのメモリフットプリントを抑えるために、Invantive UniversalSQL が内部でも頻繁に利用しているメカニズムです。
データが異なるバリアントで返されるという既知の問題はありません。OData フィードには登録情報のみが含まれており、パディングなどは一切ありません。
ODataのデータは、ブラウザでInvantive Cloud Monitoringのリクエストに対応するURLを開くことで、読み取り可能なテキストとして確認できます。エンコーディングについても、Edgeやその他のChromiumベースのブラウザのDevToolsで、HTTPヘッダーを通じて確認可能です。
これがMicrosoftドライバーの制限である可能性は否定できません。もしそうである場合、以下のような代替案があります。
32ビットのメモリ制限に縛られないPower BI環境を使用する。
現在ベータ版であるInvantive CloudのTDS(Microsoft SQL Server)アクセスポイントとメモリフットプリントを比較する。
行数および/または列数を制限する。
Microsoftに問題を報告する。
もし万が一、同じ値(テキスト、数値、GUIDなど)であるにもかかわらず、ODataフィード内で異なる表現が見つかった場合は、該当するテーブル名およびカラム名を明記の上、いくつか例を添えてお知らせください。
2vpg
2026 年 2 月 26 日午後 10:25
10
ご返信ありがとうございます。もし本当にそちらからそのように提供されていたのなら、これまでにも何度か問題が起きていたのではないかと思っていました。Microsoftに確認してみますが、そちらほど迅速で親切な対応をしてくれるか心配です(笑)
forums
2026 年 2 月 27 日午前 8:14
11
私たちのサービス姿勢に寄せていただいた信頼に感謝いたします。いつもうまくいくとは限りませんし、時にはまったくうまくいかないこともありますが、できる限り良いサービスを提供しようという意図を持っています。
この画面自体は私たちにとって馴染みのないものでしたが、Invantive UniversalSQLはPower Queryと多くの概念を共有しています。これには技術的な要素もいくつか含まれます。両者ともMicrosoft .netで動作するPC上で動きます。Microsoft .net内では、すべてのテキスト(「文字列(string)」)は、たとえ複数が同じ値を持っていても、それぞれ別物として扱われます。これは他の多くのデータ型についても同様です。
値を共有する方法はいくつかありますが、実際には常にプログラマーによる意識的な判断が必要です。この判断を誤ると、メモリリーク(memory leak)のような大きな悪影響を及ぼす可能性があります。この概念についての詳しい説明は以下をご覧ください。
In computer science, string interning is a method of storing only one copy of each distinct string value, which must be immutable. Interning strings makes some string processing tasks more time-efficient or space-efficient at the cost of using more time when the string is created or interned. The distinct values are stored in a string intern pool. The one copy of each string is called its intern and is typically looked up by a method of the string class, for example String.intern() in Java. All c...
UniversalSQLエンジンは一般的に、頻繁に出現することがわかっている非常に限られた数の値を固定的かつ一元的に記憶します。例えば定数や会社名などがこれに該当します。
さらに、このエンジンは結果セット(result set)を扱います。これらは一般的に「疎配列(sparse array)」に基づいており、つまり行内の空でない値をまとめて表す一連の値です。「疎(sparse)」というのは、数千(多くは空の)列を持つテーブルでのメモリ使用量を抑えるために、間に「隙間」が存在するためです。
結果セットには通常、一連の共有オブジェクトが付随します。例えばテキストはここで一元的に記憶されるため、繰り返し使用する際には参照だけで済みます。処理の過程では、これらの共有オブジェクト群はさまざまな方法で圧縮され、解放されます。ある歴史的な例がそれを示しています。筆者(本稿の執筆者)の些細な入力ミスにより4.5テラバイトものデータを含むクエリ結果セットが、わずか32GBの作業メモリに収まったのです。
この手法はまた、出力側で異なるテキストが生じる可能性が低いことも保証します。なぜなら、それらは同じ基盤を共有しているからです。
Power Queryも結合(join)を適用する際に同様の仕組みを使っているようで、どうやら「ハッシュ結合(hash join)」として実装されているようです。これはUniversalSQL内の結合戦略の1つでもありますが、UniversalSQLにはいわゆる「ネステッドループ結合(nested loop join)」もあります。例えばSQLヒントのjoin_setを使えば切り替えることも可能です。
ハッシュを用いた変換テーブル(「辞書(dictionary)」)を構築する際には、追加の過程で既にその値が存在するかどうかを確認する必要があります。これはMicrosoft .netにおいて必ずしも自明なことではありません。
forums
2026 年 5 月 29 日午後 3:13
12
この質問は、1週間の非アクティブ状態の後、自動的にクローズされました。最新の回答が解決策としてマークされています。
問題が再発した場合は、新しいトピックで質問を再度投稿してください。新しい質問には、このトピックへのリンクを含めるために、そのURLをテキストに貼り付けてください。